Von Beobachtungen zu Modellen
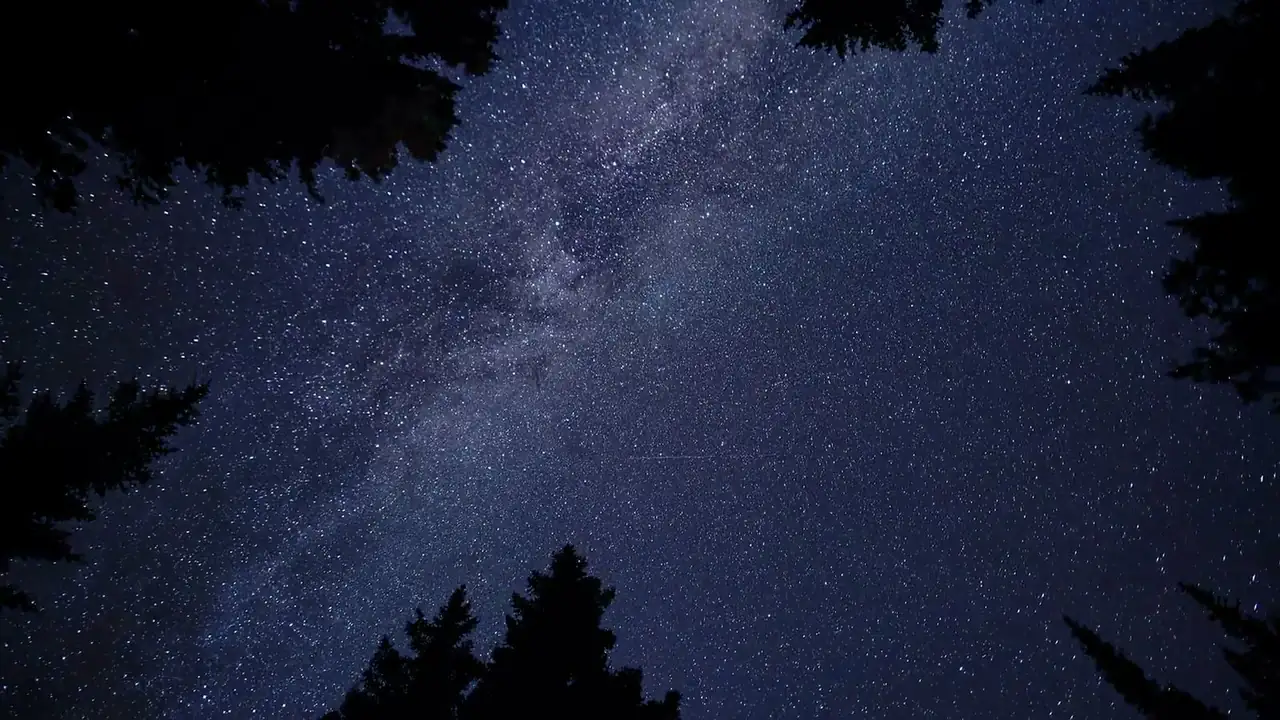
Mich interessiert, wie man aus Beobachtungen wissenschaftliche Erkenntnisse zieht und wie maschinelles Lernen dabei helfen kann. Ein Beispiel aus der Astronomie zeigt gut, was ich damit meine. Wahrscheinlich haben Menschen schon immer nachts in den Himmel geschaut und sich gefragt, was es mit den Sternen auf sich hat. Schon vor sehr langer Zeit dürfte einigen aufgefallen sein, dass manche Sterne sich bewegen. Das sind die Planeten. Wer noch länger hinsieht, stellt fest, dass sie Bahnen zu folgen scheinen.
Wie aber lassen sich diese Bewegungen vorhersagen, und welchen Gesetzmäßigkeiten folgen sie?
Das griechische Modell
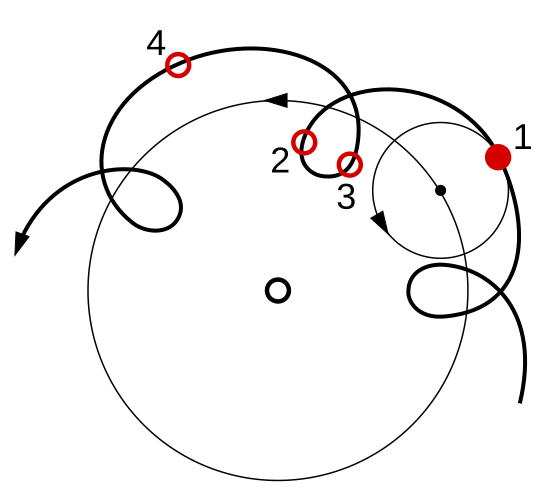
Die alten Griechen glaubten, alle Planeten bewegten sich auf Kreisbahnen um die Erde. In ihrem Bild steht die Erde im Mittelpunkt, Sonne und Planeten drehen sich um sie.
Das Keplermodell
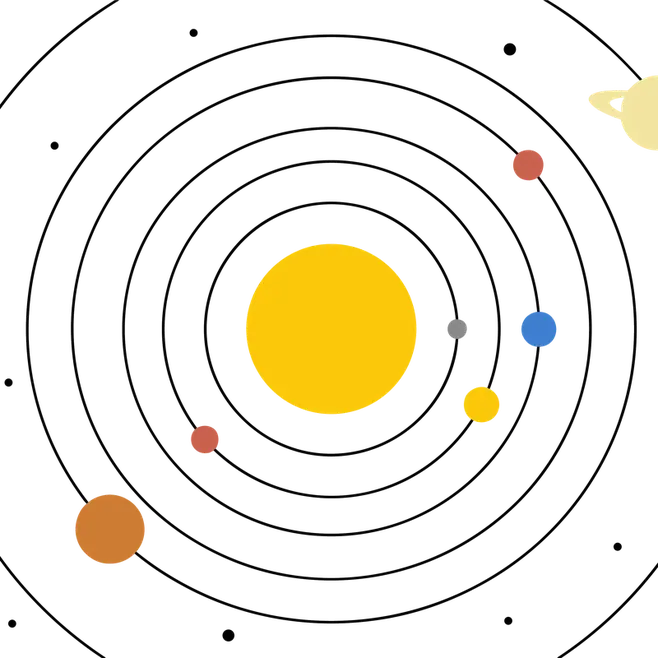
Heute wissen wir, dass sich die Bewegungen am Nachthimmel viel besser beschreiben lassen, wenn nicht die Erde, sondern die Sonne in der Mitte steht und die Planeten sie auf Ellipsenbahnen umkreisen. Diese Theorie konnten wir allein aus der Beobachtung des Nachthimmels lernen.
Wissenschaftliche Daten
Auf ganz ähnliche Weise will das wissenschaftliche maschinelle Lernen Gesetzmäßigkeiten für andere Probleme finden. Nehmen wir statt des Nachthimmels zum Beispiel Mikroskopiedaten. Lassen sich dann automatisiert und direkt aus den Daten die Gesetzmäßigkeiten ableiten, denen das untersuchte System folgt?
Und die KI?
Die Methoden, die wir dafür benutzen, sind zum Teil dieselben wie in der KI-Forschung.
Denkende Computer
Von den Planeten nun zu den Computern. Wenn ich von »denkenden Computern« spreche, meine ich große Sprachmodelle wie ChatGPT. Die Mechanismen, mit denen Sprachmodelle trainiert werden, nutzt auch das wissenschaftliche maschinelle Lernen, um Modelle aus wissenschaftlichen Beobachtungen zu lernen. Letztlich geht es immer darum, aus Daten ein Modell abzuleiten. Im Folgenden geht es um die grundlegenden Lernprinzipien, nach denen maschinelles Lernen funktioniert und die Anwendungen wie ChatGPT erst ermöglichen.
Was macht ein Sprachmodell eigentlich? Wer ChatGPT benutzt, kann beobachten, dass die Wörter eines nach dem anderen auf dem Bildschirm erscheinen. Das ist kein bloßer optischer Effekt. Tatsächlich wird immer nur ein Wort nach dem anderen erzeugt, und das Problem, das ein Sprachmodell löst, ist die Frage, welches Wort in diesem Kontext als Nächstes kommen sollte. Das ist vielleicht von der Smartphone-Tastatur bekannt. Wer »Ich fahre morgen nach« tippt, bekommt mögliche nächste Wörter vorgeschlagen. Tippt man immer wieder einen der Vorschläge an, entsteht ein ganzer Text. Ein Sprachmodell wie ChatGPT macht dasselbe, nur viel ausgereifter.
Ich fahre morgen nach
Damit stellen sich zwei Fragen. Wie schafft man es, dass dieses Vervollständigen so gut funktioniert, dass es wie Denken aussieht? Und haben Sprachmodelle wie ChatGPT dabei wirklich etwas Fundamentales über das menschliche Denken und über Sprache gelernt?
Ein naiver Ansatz für ein Sprachmodell
Gehen wir einen Schritt zurück und überlegen, wie ein Programmierer ein Sprachmodell entwickeln könnte. Angenommen, wir haben einen einfachen Computer und wollen ein Programm entwerfen, das Wörter und Sätze so vorhersagt, dass das Ergebnis klingt, als hätte es ein Mensch geschrieben. Dafür müssen wir irgendwie die Regeln der Sprache einfangen, anders geht es nicht. Computer sind gut darin, exakte Anweisungen auszuführen und dabei Symbole und Zahlen zu manipulieren. Gelingt es uns also, geschriebene Sprache auf ein System exakter Regeln herunterzubrechen und diese für den Computer verständlich aufzuschreiben, sollten wir unser Sprachmodell programmieren können. Genau das ist allerdings extrem schwierig. Zwar gibt es die Linguistik und grammatikalische Regeln, aber wer schon einmal versucht hat, eine Fremdsprache zu lernen, weiß, dass es viele Regeln und noch mehr Ausnahmen gibt.
So wie die alten Griechen aus ihren Beobachtungen des Nachthimmels nicht herausgefunden haben, dass die Erde um die Sonne kreist, so haben auch wir keine vollständige Erklärung dafür, wie Sprache funktioniert.
Sprachmodelle wollen implizit gelernt sein
Wir können ein Sprachmodell aber aus einem großen Textkorpus herausdestillieren. OpenAI hat für die Entwicklung von ChatGPT große Teile des Internets gesammelt, sprich riesige Mengen an Text aus Büchern, Online-Foren und Dokumenten. Mit diesen hat das Unternehmen ein Sprachmodell trainiert, das die Regeln der Sprache aus dem Textkorpus implizit herausdestilliert. Wir geben dem Computer also nicht vor, wie Sprache zu bilden ist, sondern nur, wie er die Regeln der Sprache aus Beispielen ableiten soll. Nach welchen Regeln das Modell am Ende tatsächlich arbeitet, wissen wir nicht.
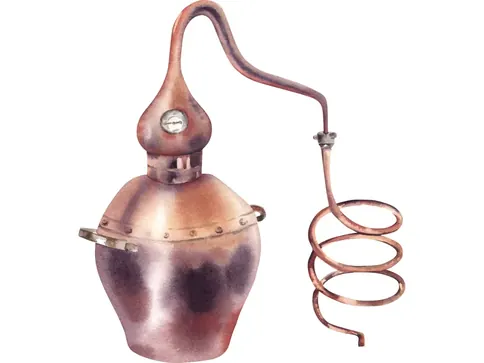
Eine Analogie macht das anschaulich. Wer den Duft einer Rose in eine Flasche füllen will, legt nicht eine einzelne Blüte in ein Fläschchen, sondern nimmt tausende Blüten und leitet Wasserdampf hindurch. Der Dampf nimmt die Duftstoffe mit, beim Abkühlen trennt sich das Öl vom Wasser, und am Ende bleiben ein paar Tropfen reines Rosenöl übrig. Das ist die Essenz.
Ein Sprachmodell entsteht genauso. Aus Milliarden von Sätzen aus dem Internet wird die Essenz der Sprache herausgearbeitet, komprimiert in einem Sprachmodell, das das Wesentliche enthält. Computer lernen Sprache, indem sie die Regeln menschlichen Denkens aus niedergeschriebenem Text extrahieren. Diese Intuition zu formalisieren, ist alles andere als einfach, aber notwendig, denn Computer arbeiten nun einmal nur mit exakten Anweisungen. Wesentlich sind dabei zwei Fragen.
Wie sieht die Destillation von Sprache aus?
Wie sieht ein Destillierverfahren für Text und Symbole als mathematisches Problem aus? Was also ist das Gegenstück dazu, unsere Blüten mit Wasserdampf zu destillieren?
Was für ein Behälter fasst die Essenz von Sprache?
Wie bringt man einen Computer dazu, nach Regeln zu handeln, die man selbst nicht ausformulieren kann? Was für eine Art Programm gleicht einer Flasche, in die man die Essenz der Sprache einfüllen kann?
Um diese beiden Fragen geht es im Folgenden.
Destillation: Kompression ist Lernen
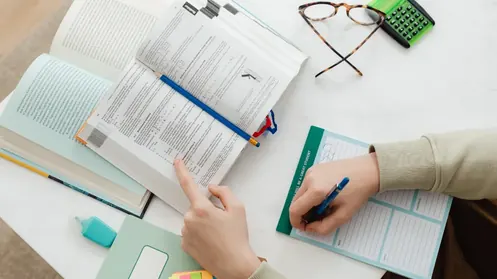
Beginnen wir mit dem Destillierverfahren. Stellen Sie sich vor, Sie sind Student und schreiben in wenigen Tagen eine Klausur, in der alle möglichen Inhalte aus den letzten 24 Vorlesungen abgefragt werden. Die Vorlesungsinhalte liegen Ihnen als Skript vor.
Ein Skript, drei Lernmethoden
Eine gängige und gute Lernstrategie ist es, die Inhalte durchzulesen und zusammenzufassen. Aber wie sieht eine gute Zusammenfassung aus?
Keine Notizen. Den Text nur durchlesen und nichts aufschreiben. Das ist wahrscheinlich nicht der beste Ansatz, wenn der Inhalt in einer Prüfung abrufbar sein soll.
Text eins zu eins abschreiben. Den gesamten Text abschreiben und versuchen, sich jeden einzelnen Satz einzuprägen, ohne die Zusammenhänge wirklich zu verstehen. Auch das ist wahrscheinlich nicht optimal.
Zusammenfassung. Im besten Fall entsteht eine Zusammenfassung auf wenigen Seiten. Sie hält die großen, wichtigen Zusammenhänge fest und lässt ergänzende Ausführungen weg. Damit werden die Informationen aus den Vorlesungen komprimiert.
Das ist nicht nur eine gute Lernmethode, sondern die Idee, Informationen komprimiert darzustellen, fängt ziemlich gut ein, was Lernen an sich bedeutet. Ausgedacht habe ich mir das natürlich nicht selbst und die Motivation, gerade das Komprimieren von Informationen als zentrales Lernprinzip zu sehen, führt direkt in die Philosophie und Wissenschaftstheorie. Denn ein Sprachmodell ist im Grunde eine Theorie darüber, wie Sprache funktioniert, und darüber, wie man Theorien aus Beobachtungen ableitet, machen sich Menschen schon lange Gedanken.
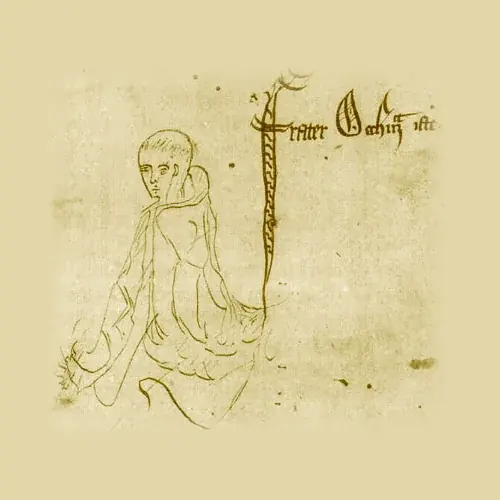
Wilhelm von Ockham zugeschrieben
entia non sunt multiplicanda praeter necessitatem
Die einfachste Erklärung ist die beste.
Das Sparsamkeitsprinzip
Ein wichtiger Grundsatz der Lerntheorie wird dem mittelalterlichen Mönch Wilhelm von Ockham zugeschrieben. Auf den Logiker und Theologen geht zurück, was heute als Sparsamkeitsprinzip oder lex parsimoniae bekannt ist. Es besagt, dass, wenn es mehrere Erklärungen für dieselben Beobachtungen gibt, die einfachste Erklärung vorzuziehen ist und dass diese einfachste Erklärung sich außerdem am besten dazu eignet, Vorhersagen zu machen. Was das konkret bedeutet, sollen die folgenden drei Fragen verdeutlichen.
Erste Frage
Warum lieben Eltern (allgemein gesprochen) ihre Kinder?
Eine mögliche Antwort lautet: »Kinder sind sehr süß. Wer sollte sein eigenes Kind nicht lieben?«
Eine andere mögliche Antwort: »Kinder brauchen die Fürsorge ihrer Eltern, um zu überleben. Wir Menschen haben uns evolutionär so entwickelt, dass wir unseren Nachwuchs lieben, weil das die Chance erhöht, dass unsere Gene in unseren Kindern weiterleben.« Beides sind gültige Erklärungen.
Zweite Frage
Warum ist Wasser durchsichtig?
Eine Antwort wäre: »Wasser absorbiert sichtbares Licht kaum. Für die Schwingungen seiner Moleküle ist es zu energiereich, für ihre Elektronen zu energiearm.« Das ist eine Erklärung.
Eine andere lautet: »Der Sehsinn hat sich evolutionär genau um das schmale Lichtband herum entwickelt, wo Wasser kaum absorbiert, da der Sehsinn ansonsten für Tiere im Wasser nutzlos wäre. Deshalb erscheint uns Wasser durchsichtig.«
Letzte Frage
Warum werden Menschen wütend, wenn sie jemand beleidigt?
Eine erste Antwort: »Der Körper schüttet Stresshormone aus.«
Eine andere Möglichkeit: »Das ist eine Reaktion, die in der Psyche angelegt ist, weil es evolutionäre Vorteile hat, auf einen Angriff mit Aggression zu reagieren. Das macht zukünftige Angriffe weniger wahrscheinlich.«
Welche Theorie ist besser?
Fasst man die drei Fragen zusammen, nennt die Erklärung links liebenswerte Kinder, die geringe Absorption von Licht in Wasser und Stresshormone. Die Erklärung rechts sagt, dass die menschliche Erfahrung evolutionär geformt ist. Welche ist besser?
Die rechte Theorie ist besser, jedenfalls in diesem Beispiel. Aber warum? Mit den Beobachtungen (mit den drei Fragen) sind schließlich beide Theorien vereinbar. Der Unterschied zeigt sich erst bei dem Versuch, weitere Fragen dieser Art zu beantworten. Die erste Theorie kommt dann wahrscheinlich nicht viel weiter, weil sie für jede Frage eine neue Grundannahme braucht.
Die zweite Theorie dagegen erklärt mit einer einzigen Annahme alle Beobachtungen.
Das ist das Sparsamkeitsprinzip in Aktion. Die einfachere Theorie ist mächtiger, weil sie mehr vorhersagen kann.
Das funktioniert natürlich nur, solange ich, der den Text schreibt, Fragen stelle, die mit der Evolution des Menschen zu tun haben. Bei einer Frage zur relativistischen Quantenmechanik helfen beide Theorien nicht weiter. Das ist aber keine Schwäche des Sparsamkeitsprinzips, sondern eine Stärke! Das Sparsamkeitsprinzip findet tatsächlich etwas über den Prozess heraus, der die Beobachtungen erzeugt.
Sie lernen etwas über den Fragesteller!
Alle meine Fragen hatten mit der Evolution des Menschen zu tun. Wer eine einfache Erklärung für sie sucht, findet also etwas über mich als Fragesteller heraus, nämlich dass ich nach der Evolution des Menschen frage und nicht nach anderen Themen. Deshalb ist das Sparsamkeitsprinzip auch ein Lernprinzip. Wer die kompakteste Erklärung für gegebene Beobachtungen findet, nähert sich dem Wesentlichen an und lernt etwas über die grundlegenden Prinzipien.
Sparsamkeitsprinzip = Lernen
- Warum lieben Eltern ihre Kinder?
- Warum ist Wasser durchsichtig?
- Warum werden Menschen wütend?
Für unser Beispiel vom Anfang heißt das, wer zu erklären versucht, wie sich die Planeten bewegen, lernt tatsächlich etwas darüber, wie das Universum funktioniert. Lässt sich die Bewegung der Planeten am besten beschreiben, indem wir die Sonne ins Zentrum des Sonnensystems setzen, dann dreht sich die Erde wahrscheinlich auch tatsächlich um die Sonne. Für meine drei Fragen heißt es, dass ich nur solche stelle, die sich mit der Evolution des Menschen beantworten lassen. Und für unser Sprachmodell heißt es, dass ein Computerprogramm, das Milliarden von Textschnipseln komprimiert darstellen kann, tatsächlich etwas über die Sprache gelernt hat, die hinter den Buchstaben und Symbolen steht.
Zu kurz
Für unseren Studenten, der seine Vorlesungen zusammenfasst, bedeutet es, dass gar nicht erst ein Modell vorliegt, wenn die Zusammenfassung zu kurz ist oder im Extremfall ganz fehlt. Dann wird auch nichts erklärt.
Zu lang
Ist die Zusammenfassung zu lang, haben wir eine Theorie, die zu viele Annahmen braucht. Sie ist nicht gut, weil sie sich nicht auf neue Fragen übertragen lässt.
Genau richtig
Genau richtig ist nach dem Sparsamkeitsprinzip eine kurze Zusammenfassung, die mit wenigen Annahmen auskommt, aber das Wesentliche enthält und so die Beobachtungen erklärt.
Für das Sprachmodell
So können wir das Sparsamkeitsprinzip auch technisch auf Sprachmodelle anwenden. Wir nehmen die Milliarden von Beispielsätzen …
… und komprimieren die Informationen möglichst stark.
Das Programm, das diese Kompression vollbringt, also einen guten Spickzettel schreiben kann, ist dann unser Sprachmodell. Es nimmt die Rolle des Studenten ein, der die Vorlesungsinhalte lernt, indem er eine gute Zusammenfassung schreibt.
Wie schreibe ich technisch den besten Spickzettel?
Wir wissen also, was ein gutes Sprachmodell ausmacht. Aber wie finden wir es? Gesucht ist das einfachste Modell, das die Textdaten gut beschreibt, also eine einfache und zutreffende Erklärung für die Beobachtungen.
Mathematisch betrachtet entspricht dieses Ziel genau dem Fall, dass wir die Entropie zwischen der Vorhersage des Modells und den Textdaten minimieren. Mit dem Wort Entropie werden einige Leser nicht viel anfangen können. Ich erwähne es der Vollständigkeit halber, denn solche philosophischen Ansätze so weit zu formalisieren, dass man damit mathematisch und auf einem Computer arbeiten kann, ist eines meiner Forschungsinteressen.
- Wir suchen
- ein gutes Modell
- das heißt
- eine kurze Beschreibung der Textdaten
- das heißt
- minimale Entropie zwischen Vorhersage und den Textdaten
- das heißt
Die Entropie zu minimieren lässt sich als mathematisch-symbolisches Problem aufschreiben, und solche Anweisungen kann ein Computer ausführen.
Was für ein Behälter fasst die Essenz von Sprache?
Damit zur zweiten Frage. Welche Art Behälter kann die Essenz von Sprache fassen? Beim Rosenöl stehen am Anfang die Blüten. Sie werden destilliert, das Ergebnis kommt in einen Behälter, und so entsteht die Essenz. Beim Sprachmodell stehen am Anfang Milliarden von Textschnipseln. Eine technisch ausformulierte Version des Sparsamkeitsprinzips macht daraus ein Sprachmodell, das besonders gut Text komprimieren kann.
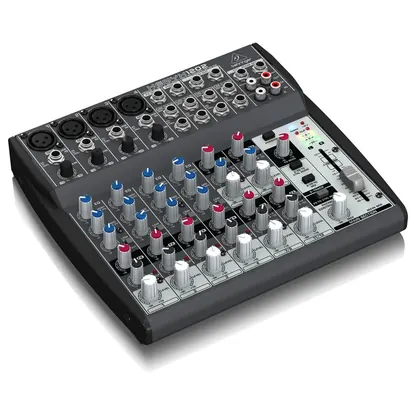
Was aber ist das Gegenstück zum Behälter? Welche Art Programm kann die Regeln von Sprache einfangen? Exakte Regeln funktionieren in der Praxis nicht, Computer aber führen nun einmal präzise Anweisungen aus. Wie geht das zusammen? Wie lässt man einen Computer unpräzise oder assoziative Vorgänge lösen? Dafür brauchen wir ein Programm, das nicht für eine bestimmte Aufgabe konzipiert ist, sondern im besten Fall beliebige Vorgänge darstellen kann, einen universellen Behälter, wenn man so will. Es wird, so viel vorweg, etwas mit einem Mischpult mit vielen Knöpfen zu tun haben.
Ein universelles Rezept
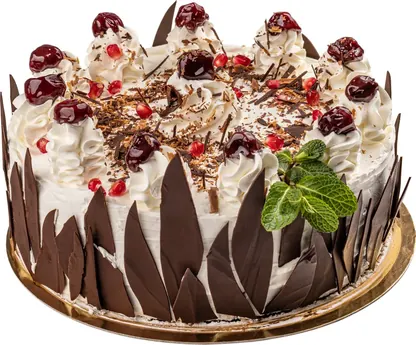
Sagen wir, wir wollen einen Kuchen backen, der so wie in unserer Kindheitserinnerung schmeckt. Viele Faktoren beeinflussen den Geschmack, zum Beispiel die Ruhezeit, Backzeit, Temperatur, Menge an Butter, Zucker und Milch. Außerdem sind diese Angaben gekoppelt. Wer mehr Eier nimmt, muss etwas Milch weglassen, damit die Konsistenz sich nicht verändert.
Mit den richtigen Werten für alle diese Angaben lässt sich im Prinzip jeder beliebige Geschmack erreichen. Ohne Zucker lässt sich mit dem Rezept sogar Brot backen oder Nudeln kochen. Ein Backrezept besteht also aus präzisen Anweisungen, aber das Ergebnis hängt von vielen kleinen Änderungen ab. Jede Mengen- oder Zeitangabe ist wie eine Stellschraube, die sich hoch- und runterstellen lässt. Damit ist ein Backrezept eine Art universelle Anweisung für alle möglichen Geschmäcker und verhält sich genauso wie der gesuchte Behälter für unsere Sprachessenz. Hier suchen wir eine universelle Anweisung für alle möglichen kognitiven Vorgänge. Schwierig ist nur, die richtigen Mengenangaben zu finden.
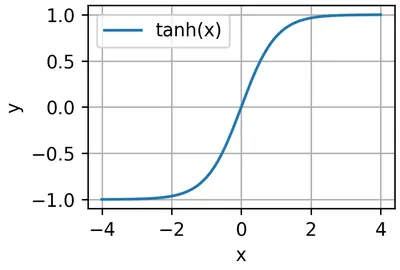
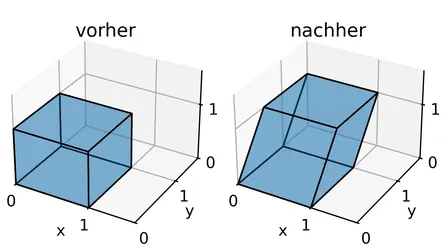
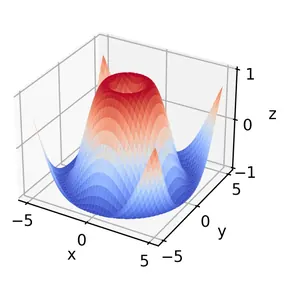
Das technische Gegenstück zu einem Backrezept mit veränderbaren Mengenangaben ist eine Klasse elementarer Kurven und Funktionen, die durch Stellschrauben miteinander verkoppelt sind. Bei Sprachmodellen sind es in der Praxis Billionen von Stellschrauben, die in einer Art neuronalem Netz miteinander verstrickt sind. Mathematisch lässt sich zeigen, dass solche Funktionen oder neuronalen Netze tatsächlich weitgehend universell sind. Mit den richtigen Einstellungen für die Stellschrauben können wir im Prinzip alles Mögliche berechnen, etwa Dinge auf Bildern erkennen oder menschliche Sprache nachahmen. Die Schwierigkeit liegt bloß darin, die Stellschrauben richtig einzustellen.
Gekoppelte Stellschrauben
Die richtigen Einstellungen alle auf einmal zu finden, ist unmöglich. Eine viel einfachere Frage lässt sich aber beantworten: »Wenn ich diesen einen Knopf ein klein wenig nach rechts drehe, wird das Ergebnis besser oder schlechter?« Diese Frage können wir für jeden einzelnen Knopf beantworten oder berechnen und dann alle Knöpfe einen kleinen Schritt in die bessere Richtung drehen. Danach stellen wir wieder dieselbe Frage und drehen wieder. Nach vielen Wiederholungen entsteht so ein gutes Ergebnis. Es ist, als würden wir das richtige Kuchenrezept finden, indem wir viele Kuchen nacheinander backen und das Rezept jedes Mal ein kleines bisschen verbessern.
Wird der Geschmack besser?
Drehen Sie an einem Knopf.
Für unser Sprachmodell heißt das, wir passen die Stellschrauben so an, dass die Zusammenfassung der Textdaten immer kürzer wird. Um diesen Vorgang zu zeigen, sind hier 25 Stellschrauben programmiert, die eine Kurve beeinflussen. Jede Stellschraube verändert die Kurve auf eine andere Art. Richtig eingestellt, können sie alle möglichen Formen erzeugen, wie eine Ellipse, ein Herz oder auch einen Elefanten. Ein Druck auf »Anpassen« zeigt, wie sich die Stellschrauben live und automatisch anpassen. Dabei wird immer wieder ausgerechnet, ob sich eine Stellschraube nach links oder nach rechts drehen muss, damit das Ergebnis besser wird. Dann dreht sich der Knopf ein wenig, und es geht von neuem los, mehrmals pro Sekunde.
Hier dasselbe noch einmal mit echten Daten statt mit einer Kurve. Mit 65 Stellschrauben soll der Computer lernen, ob auf einem winzigen Bild von 8 × 8 Pixeln eine handgeschriebene 3 zu sehen ist. Zu jedem Pixel gehört ein Knopf, dazu kommt ein Grundwert. Niemand schreibt dem Computer vor, wie eine 3 aussieht. Er bekommt nur Beispiele und dreht nach jeder kleinen Gruppe von Bildern alle Knöpfe einen winzigen Schritt in die bessere Richtung.
65 Stellschrauben
Ist das eine 3?
Selbst zeichnen
Ein Sprachmodell funktioniert genauso, nur dass es Billionen solcher Knöpfe hat statt 25 oder 65 und dass die Knöpfe nicht mit einer Kurve zusammenspielen, sondern mit der Vorhersage des Modells.
Zusammenfassung
Zum Schluss das Wichtigste in fünf Fragen.
Was bedeutet Denken im Kontext von KI?
Immer das nächste Wort vorhersagen. Ein einfacher, rekursiver Vorgang, der wie menschliches Denken aussieht.
Was ist ein Sprachmodell?
Im Prinzip bloß eine Theorie darüber, wie Sprache funktioniert.
Wie lernt man ein Modell?
Mit dem Sparsamkeitsprinzip, das wir besprochen haben.
Wie sehen solche Modelle auf dem Computer aus?
Billionen von gekoppelten Stellschrauben, die zusammen wie ein universelles Rezept funktionieren. Das ist die Antwort auf die Frage nach dem Behälter, der die Essenz von Sprache fassen kann.
Wie findet man die richtige Einstellung der Stellschrauben?
Durch Milliarden von kleinen Anpassungen. Indem man sie so lange in kleinen Schritten justiert, bis das Ergebnis gut ist.
Abbildungen und Quellen
- Sternenhimmel: Drew Cotten, 7PM to 7AM Night Sky Stars Timelapse, YouTube.
- Epizykel-Diagramm: MLWatts, Wikimedia Commons, gemeinfrei.
- Ockham-Zeichnung: »frater Occham iste«, Handschrift der Summa Logicae, 1341, Gonville and Caius College, Cambridge, MS 464/571, fol. 69r, Wikimedia Commons, gemeinfrei.
- Mikroskopie-Film: Schaller, Weber, Semmrich, Frey, Bausch, Polar patterns of driven filaments, Nature 2010, Zusatzmaterial.
- Lehrbuch: Ellen Brandner, Germanistische Linguistik, Stark Verlag 2024.
- Ziffern-Daten: scikit-learn, CC BY 4.0.
- KI-Kopf, Roboter, Rosenblätter, Spickzettel, Sonnensystem, Zutaten, Gerichte und weitere Stockbilder: Adobe Stock.
- Lernfoto: Kaboompics, Pexels.
- Wikipedia-Logo: Wikimedia Foundation.
- Kurve, Würfel und Fläche: mit Matplotlib erstellt.
- Produktfotos: Behringer, Xavax, Diamant, Wiener Zucker, Dr. Oetker, Lesebrille.de.

